12 min de lecture
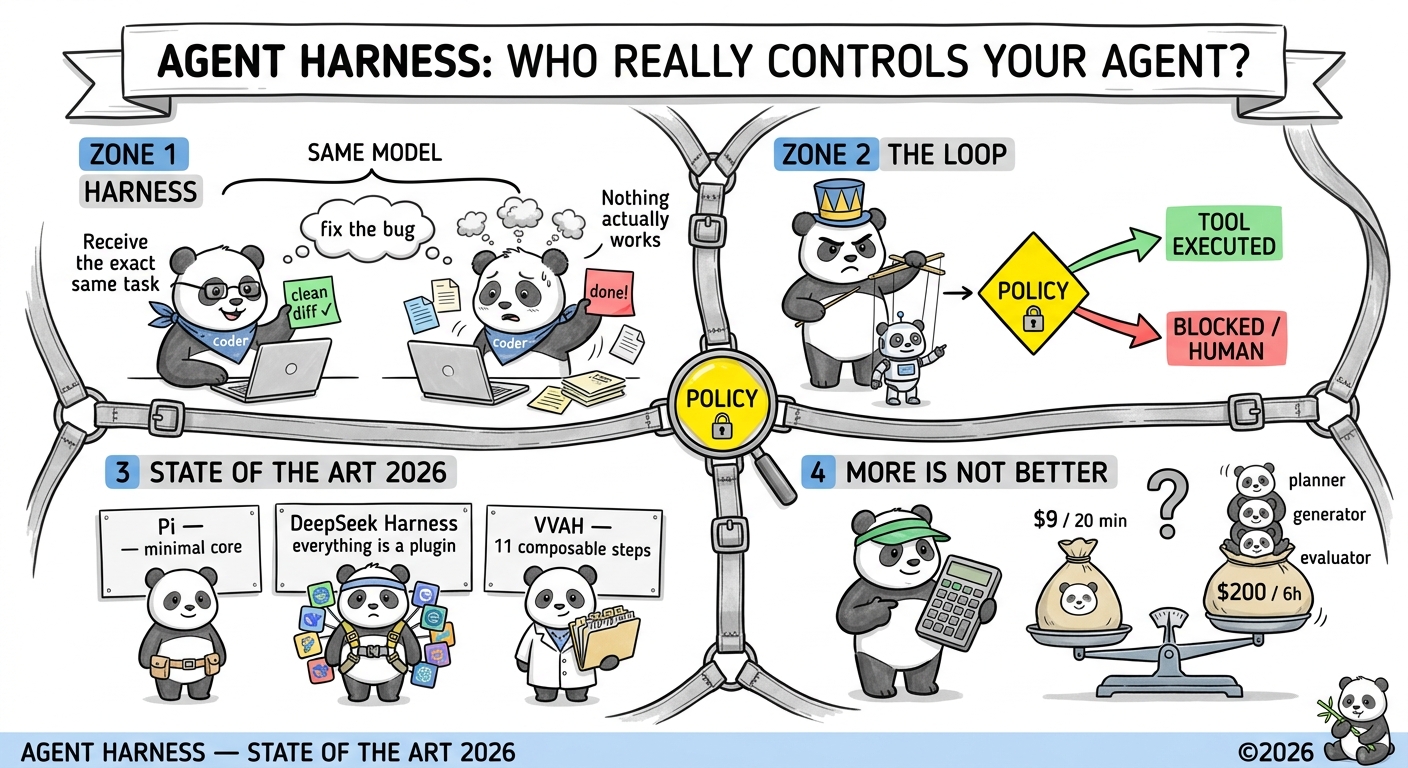
Donnez à deux agents de codage le même modèle, le même dépôt, le même bug. Le premier trouve le code d’authentification, lance un test ciblé, voit l’échec, change deux lignes, relance les tests, rend un diff propre. Le second ouvre des fichiers sans rapport, appelle la mauvaise commande, sature son contexte de bruit et annonce que le travail est terminé. Même modèle.
La différence, c’est le harness.
Je passe une bonne partie ici a analyser des incidents où un agent IA fait quelque chose qu’il n’aurait pas dû faire et parler d’IA a tout va. Et à chaque fois, ou presque, j’écris presque la même phrase sous une forme ou une autre : le modèle a fait ce qu’on lui demandait, c’est la couche en dessous qui n’a pas tenu.
Dans Comment and Control, le LLM a produit une commande shell plausible à partir d’un texte ; ce sont le validateur de commande, la frontière de sandbox et l’allowlist de domaine qui ont échoué.
Cette couche a un nom, elle commence à avoir une littérature, et elle a même une discipline d’ingénierie qui se constitue autour d’elle : le harness engineering. Je trouve utile de poser proprement le vocabulaire une bonne fois, parce que je vais m’en servir dans les prochaines analyses de vulnérabilité plutôt que de réécrire à chaque fois “la couche autour du modèle”.
Note du PandaRedacteur: harness(en anglais) == harnais(en francais). To harness == exploiter. Je vous laisse comprendre ce que vous pouvez/voulez comprendre avant d’avancer..
Définition du bousin
Un agent harness est le logiciel qui fait tourner un modèle comme agent.
Concrètement, il prépare ce que le modèle peut voir, appelle le modèle, lit l’action que celui-ci veut entreprendre, exécute cette action, enregistre ce qui s’est passé, et renvoie le résultat utile pour l’étape suivante. La boucle tourne jusqu’à ce que la tâche soit terminée, bloquée, ou remontée à un humain.
Sauf qu’un harness réel ne se limite jamais à cette boucle. Il gère aussi les fichiers, les limites de contexte, la mémoire, les permissions, les approbations, les sandboxes, les retries, les checkpoints, les traces, les sous-agents, et la règle qui décide de ce que “terminé” veut dire.
Le modèle décide. Le harness détermine ce que cette décision a le droit de devenir.
Les frontières ne sont pas encore standardisées ; le vocabulaire flotte d’un projet à l’autre. Voici la découpe que je retiens et que j’utiliserai par la suite :
| Brique | Rôle |
|---|---|
| Modèle | Décide quoi faire à l’étape suivante |
| Outil | Exécute une action définie et bornée |
| Sandbox | L’endroit où le travail risqué peut tourner |
| Runtime | Maintient le process vivant |
| Harness | Coordonne tout ça dans le comportement d’un agent particulier |
Note du PandaRedacteur : dans 80% des slides d’architecture agentique que je vois passer, ces cinq briques sont regroupées dans un seul rectangle marqué “Agent”. Vous savez maintenant lequel des cinq échoue quand la démo part en vrille.
Comment on en est arrivé là
Les premières applications LLM étaient simples : texte entrant, texte sortant. Puis du fine-tuning. Puis du RAG. Puis ReAct a proposé quelque chose de structurellement différent : le modèle raisonne sur un problème, agit, observe le résultat, et continue à partir de cette nouvelle preuve. Le function calling a rendu ces actions exécutables de façon structurée plutôt qu’à coups d’expressions régulières sur du texte libre.
Ensuite, les tâches se sont allongées, et chaque allongement a ajouté une exigence : chercher dans un gros dépôt, survivre à une commande qui échoue, ne pas perdre sa progression, tenir dans les limites de contexte, reprendre d’une session à l’autre. Une par une, la boucle a absorbé la gestion du contexte, l’état, la sécurité, la récupération et la vérification. Ce système plus large, c’est ce qu’on appelle aujourd’hui un harness.
flowchart LR
    A["Préparer le contexte<br/>(instructions, état, mémoire)"] --> B["Appeler le modèle"]
    B --> C["Lire l'action demandée"]
    C --> D{"Politique du harness<br/>(permissions, approbations,<br/>sandbox, budget)"}
    D -->|"autorisée"| E["Exécuter l'outil"]
    D -->|"refusée / à approuver"| F["Blocage ou<br/>human-in-the-loop"]
    E --> G["Enregistrer trace<br/>+ checkpoint"]
    G --> H{"Terminé ?"}
    H -->|"non"| A
    H -->|"oui"| I["Rendre le résultat"]
    F --> G
    style D fill:#fff3cd,stroke:#ffc107,stroke-width:2px
    style F fill:#f8d7da,stroke:#dc3545,stroke-width:2px
    style I fill:#d4edda,stroke:#28a745,stroke-width:2px
Regardez bien le losange jaune. C’est tout ce qui sépare un agent de codage d’un exécuteur de commandes arbitraires piloté par du texte venu d’internet. C’est aussi, dans les faits, le composant le moins souvent audité de la chaîne.
La boucle en conditions réelles
Prenons une tâche banale : “corrige le bug de login et vérifie que les tests existants passent toujours”.
- Avant même le premier appel au modèle, le harness charge les instructions du dépôt, la branche courante, les commandes de test et une carte approximative du projet. Il ne colle pas le dépôt entier dans le prompt ; c’est déjà une décision d’ingénierie, et elle est prise sans le modèle.
- Le modèle demande à chercher le gestionnaire d’authentification. Le harness exécute la recherche et retourne les fichiers correspondants.
- Le modèle ouvre deux fichiers, propose un patch, demande à lancer un test ciblé.
- Le test échoue. Cet échec devient une nouvelle preuve renvoyée au modèle, qui révise le patch et relance le test.
Autour de cette boucle, le harness impose des règles qui, elles, ne doivent surtout pas dépendre de la mémoire du modèle : les commandes tournent dans un sandbox, les secrets restent hors de l’espace de travail, une commande destructive exige une approbation, les fichiers modifiés et les résultats de tests sont sauvegardés, et le run reprend depuis un état persistant si le process worker disparaît.
On comprend mieux, du coup, pourquoi Codex ou le Claude Agent SDK représentent autant de travail : l’enveloppe autour de l’API fournit l’espace de travail, contrôle les actions, porte l’état et vérifie le résultat. L’Agents SDK d’OpenAI rend d’ailleurs cette séparation explicite en gardant l’état du harness en dehors du compute sandbox, pour qu’un conteneur en échec puisse être remplacé sans perdre tout le run ; l’architecture Managed Agents d’Anthropic suit la même découpe.
Note du PandaRedacteur : “les secrets restent hors de l’espace de travail” est une phrase de trois mots dans une doc produit, et six mois de dette technique dans la vraie vie. Je l’ai vérifié suffisamment de fois pour ne plus la croire sur parole.
L’état de l’art du harness…
Il n’existe pas de design de harness gagnant. Les projets font des paris différents sur la quantité de structure à fournir d’office, et ce pari est le vrai critère de choix.
Les harnesses de codage
Pi mise sur un petit noyau : une boucle de codage terminal utile, mais qui laisse le plan mode et les sous-agents hors du système par défaut. Les développeurs ajoutent extensions, skills, templates de prompt, providers et packages selon leur besoin. L’idée assumée : changer le harness autour du workflow, plutôt que le workflow autour du harness.
DeepSeek Harness pousse la modularité beaucoup plus loin. Modèles, outils, skills, sessions, sandboxes, stockage, boucles, scheduling, et même l’interface sont des plugins construits sur Cordis. Le détail qui m’intéresse le plus : il enregistre ce que le modèle voit dans un log append-only, et reprise, fork, recherche et replay utilisent tous le même flux d’événements. Pour de la recherche, c’est précieux, on peut faire varier une couche pendant que le reste reste fixe. Pour un forensic post-incident, c’est encore mieux. Le projet est en preview développeur, ses APIs vont bouger.
OpenCode et OpenHands sont plus orientés produit. OpenCode combine règles de projet, outils, skills, MCP, agents primaires et sous-agents dans une expérience de codage prête à l’emploi. OpenHands sépare son SDK, ses outils, son workspace et son serveur d’agent, pour que la même logique tourne en local, dans un sandbox, ou derrière un service distant.
Les harnesses pour constructeurs d’applications
Un autre groupe ne vise pas le terminal du développeur mais l’équipe qui met un agent en production :
- LangChain Deep Agents fournit un harness préassemblé sur LangGraph
- Microsoft Agent Framework Harness ajoute planification, suivi de tâches, compaction, mémoire de fichiers, approbations et observabilité
- Pydantic AI Harness expose un comportement comparable sous forme de capacités typées attachées à un agent existant
Et bien sûr VVAH, que j’ai analysé en juillet (Visa open-source son harness agentique), qui est un harness spécialisé de bout en bout : onze étapes, chacune un skill composable, avec panel de validation adversarial. Relisez-le avec le vocabulaire de cet article en tête, la lecture change complètement.
| Projet | Pari de conception | Ce que ça implique pour vous |
|---|---|---|
| Pi | Noyau minimal | Vous écrivez vous-même vos garde-fous ; liberté maximale, responsabilité maximale. |
| DeepSeek Harness | Tout est plugin, log append-only | Excellente traçabilité et replay ; APIs instables, preview développeur. |
| OpenCode | Expérience de codage intégrée | Règles projet, MCP et sous-agents prêts à l'emploi ; surface d'entrée large à cadrer. |
| OpenHands | SDK / outils / workspace / serveur séparés | Même logique en local, en sandbox ou en service distant ; découpe favorable à l'isolation. |
| LangChain Deep Agents | Harness préassemblé sur LangGraph | Démarrage rapide côté application ; le comportement par défaut devient votre politique par défaut. |
| Microsoft Agent Framework Harness | Planification + observabilité + approbations | Le plus proche d'attentes d'entreprise, incluant les points d'approbation. |
| Pydantic AI Harness | Capacités typées greffées | S'ajoute à un agent existant sans tout réécrire ; typage utile pour valider les frontières. |
La recherche comme capacité, cas d’école
À travers tous ces systèmes, un harness se lit comme une collection de capacités que le modèle peut mobiliser quand la tâche l’exige. La recherche web ou documentaire en est l’exemple le plus parlant : un modèle ne peut pas répondre de façon fiable sur un sujet très récent depuis sa seule mémoire. Le harness doit reconnaître qu’une information fraîche est nécessaire, chercher, conserver les dates de publication et les sources, filtrer le bruit, et retourner une preuve utilisable au modèle avant qu’il n’écrive sa réponse.
Notez au passage que chaque mot de cette phrase est aussi une surface d’attaque : “chercher” ouvre un canal d’entrée non fiable, “filtrer le bruit” est une décision de confiance, “retourner une preuve utilisable” est une injection de contenu tiers dans le contexte. C’est exactement le terrain de GhostSplice.
Plus de harness n’est pas toujours mieux
Un harness peut débloquer une capacité déjà présente dans le modèle. Il peut tout aussi bien ajouter du coût, de la latence, et des règles dont le modèle n’a plus besoin.
Anthropic l’a mesuré sur une expérience de génération d’application longue durée :
- Un agent seul : 20 minutes, 9 dollars.
- Un harness planificateur + générateur + évaluateur : six heures, 200 dollars. Plus de vingt fois plus cher, mais une application nettement plus riche et fonctionnelle.
Puis le modèle s’est amélioré. Avec un Claude plus fort, Anthropic a d’abord supprimé les resets de contexte, puis la structure en sprints qui aidait le modèle précédent à rester cohérent. L’évaluateur continuait à aider sur les parties difficiles, mais était devenu un surcoût pur pour tout ce que le modèle plus récent gérait seul.
L’arbitrage du harness engineering tient en trois lignes :
Un harness trop faible étouffe la capacité du modèle. Un harness trop lourd la paye deux fois, en argent et en latence. Et il faut le réajuster à chaque nouveau modèle plus puissant.
Ce qu’on vise, c’est donc la quantité minimale de structure qui rend le modèle actuel fiable pour la tâche actuelle. Pas le harness le plus complet. Votre choix d’aujourd’hui a une date de péremption, autant la mettre au backlog tout de suite.
Note du PandaRedacteur : traduction : votre plateforme agentique interne construite sur six mois autour d’un modèle de 2025 est peut-être devenue, en 2026, une machine à ralentir un modèle qui n’en a plus besoin. Personne n’aime cette phrase. Elle reste vraie.
Ce qu’il faut regarder avant d’adopter ou de durcir un harness
Sept questions, dans cet ordre. Si vous n’avez pas de réponse aux quatre premières, le reste est prématuré.
- Où est la frontière d’exécution ? Quel process, quel conteneur, quel utilisateur exécute réellement les outils.
- La liste de ce qui exige une approbation, et le nom de qui approuve. Explicite, versionnée, testable, et surtout pas planquée dans un prompt système. Sur la dérive lente de cette liste, voir la normalisation de la déviance du human-in-the-loop.
- Où sont les secrets ? Hors de l’espace de travail, hors de l’environnement du process qui exécute les outils, hors des traces. Les trois, pas deux sur trois.
- L’inventaire des canaux capables d’injecter du texte dans le contexte : issues, résultats d’outils, descriptions d’outils MCP, résultats de recherche web, fichiers du dépôt. Chacun est une entrée non fiable ; c’est tout le sujet de GhostSplice et de Comment and Control.
- Ce que dit la trace, et combien de temps on la garde. Un harness sur lequel on ne peut pas rejouer un run est un harness sur lequel vous ne ferez aucun forensic.
- Le plafond de dépense global. Pas par étape, pas par finding : global.
- Et pour finir, ce qui change de comportement quand on change de modèle.
Sur le durcissement des permissions d’outils, l’article CoreBreak et le framework de contrôle AWS pour agents de codage donnent des grilles directement applicables. Et si vous vous demandez pourquoi je reviens sans arrêt sur les approbations, relisez le mode YOLO.
📚 Références
- Model Context Protocol
- OWASP Top 10 for LLM Applications
- VVAH : Visa open-source son harness agentique
- Comment and Control : une issue GitHub suffit à voler les secrets de votre CI
- GhostSplice : l’agent recolle tout seul l’instruction malveillante
- CoreBreak : autorisation d’outils chez AWS, Google et Vercel
- Le framework de contrôle AWS pour les agents de codage
- Mode YOLO : bonnes pratiques pour les agents IA
- Agent Skills : les risques vus par la CSA
- MCP : authentification sécurisée et spec OAuth
- Human-in-the-loop : la normalisation de la déviance