8 min de lecture
~11 minutes
Un agent qui invente un appel d’outil, ça arrive tous les jours dans vos logs de prod ; vous appelez ça une hallucination, vous ajoutez un garde-fou de plus, vous priez. TypeSafe AI propose une autre approche : sortir carrément le générateur de texte de la boucle de décision. Leur modèle Jev ne rédige rien, il classe. Et LangChain vient de le brancher dans son harness comme filtre pré-exécution.
Un modèle qui ne génère plus rien
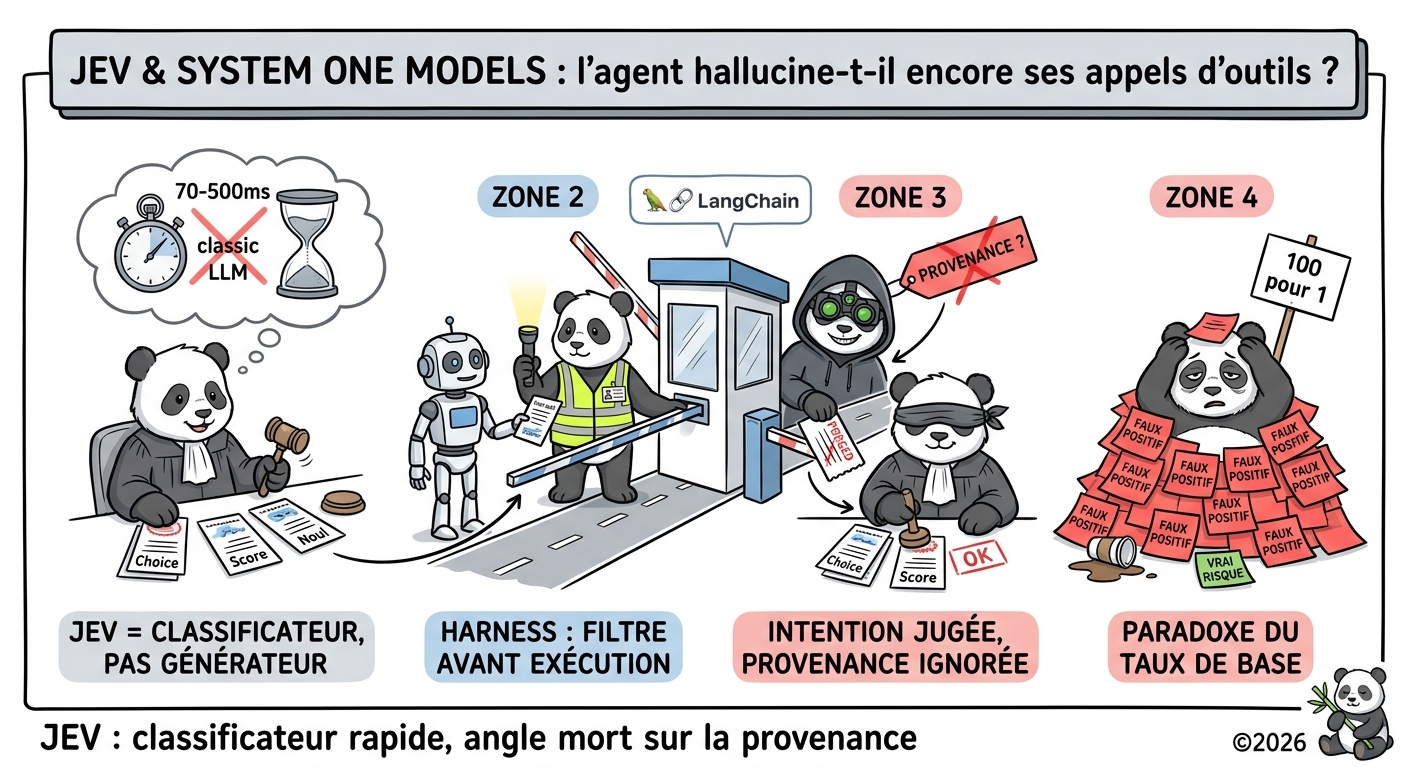
TypeSafe AI vient de lancer ce qu’ils appellent une nouvelle catégorie de modèles : les System One Models. Le nom fait référence au système 1 de Kahneman, la décision rapide et intuitive plutôt que le raisonnement délibéré. Leur premier produit, Jev, illustre bien la promesse : au lieu de générer du texte token par token comme n’importe quel LLM, il prend un état non structuré en entrée et retourne des décisions probabilistes typées en sortie. Trois familles de questions couvrent tout le catalogue : Choice (sélection parmi des options avec probabilités), Score (notation sur une échelle) et Noul (oui/non probabiliste), point final ; pas de mode texte libre en secours.
L’argument commercial tient en deux chiffres qui sonnent bien en démo : jusqu’à 200x plus rapide et 400x moins cher qu’un LLM comparable, avec des latences annoncées de 70 à 500ms contre 3 à 329 secondes. L’entraînement change aussi de méthode : du RLCD (Reinforcement Learning for Calibrated Decisions) à la place du RLHF ou du RLVR habituels, avec pour objectif des probabilités calibrées plutôt qu’une réponse plausible.
Note du PandaRedacteur : un modèle qui ne sait dire que “A, B ou C avec telle probabilité”, ça s’appelle un classificateur depuis les années 90. Ce qui change, c’est qu’on lui colle une intelligence de “frontière” dessus et qu’on le vend comme une nouvelle catégorie de modèle plutôt que comme du bon vieux ML appliqué à un état d’agent.
Ce que la couverture grand public en retient
Olivier Sauvage a publié une bonne synthèse de Jev côté usage business, avec des cas concrets utiles pour qui n’a pas d’équipe data en interne : tri automatique d’e-mails, détection d’urgence, optimisation SEO, le genre de tâche de classification massive où une PME ou une TPE n’a ni le budget ni la patience pour un LLM générique. Son article vulgarise bien l’idée centrale : un modèle qui répond vite et pas cher sur une décision fermée plutôt que de rédiger un paragraphe pour dire “oui” ou “non”.
Note du PandaRedacteur : Olivier Sauvage cite 193,6x plus rapide et 444,6x moins cher, TypeSafe AI annonce 200x et 400x dans son propre post. Deux sources sérieuses, deux chiffres assez proches sur le même produit, à quelques jours d’écart.
Son article reste silencieux sur trois points : la sécurité, la confidentialité des données transmises au classificateur, et les conditions dans lesquelles cette automatisation devient un vecteur d’abus plutôt qu’un gain de productivité. Choix éditorial défendable pour un papier orienté business ; mais une PME qui branche Jev sur son tri d’e-mails sans se poser ces questions reproduit exactement le problème que je documente plus loin pour les agents LangChain, avec moins de moyens pour l’auditer après coup.
Le harness selon LangChain
C’est là que l’article de LangChain devient intéressant pour qui s’occupe de sécuriser des agents plutôt que de vendre des benchmarks. J’ai posé le vocabulaire du harness dans un article dédié ; je ne le refais pas ici, je m’en sers. Ce que Jev vient occuper, c’est une case très précise de ce vocabulaire : le point d’approbation, celui que j’avais listé en question n°2 des sept à poser avant d’adopter un harness. Leur intégration s’appuie sur TypeSafeClassifier, qui traite un état et plusieurs questions en parallèle dans une seule requête, et sur un composant baptisé AutoModeMiddleware : il classe chaque appel d’outil avant exécution et bloque ceux jugés risqués.
Cette section continue dans la version complète, disponible gratuitement pour tous les abonnés Substack.
Ce que ça change vraiment (ou pas)
J’avais deja décortiqué ce risque sous l’angle MCP dans MCP05 : Command Injection & Execution : le problème de fond n’est pas que l’agent “hallucine” au sens strict, c’est qu’il dispose d’une capacité d’action que personne n’a proprement bornée en amont. Le sandboxing, le RBAC, la confirmation humaine avant action destructive ; tout ça existait avant Jev, et continuera d’exister après. Ce que Jev ajoute, c’est un filtre de classification rapide et bon marché entre la décision de l’agent et l’exécution réelle, ce qui permet de faire ce contrôle à chaque appel d’outil sans plomber la latence ni le budget.
Cette section continue dans la version complète, disponible gratuitement pour tous les abonnés Substack.
Note du PandaRedacteur : “zéro hallucination garantie” sur les types de sortie, oui. Zéro mauvaise décision sur le fond, certainement pas ; un classificateur bien entraîné peut être bien entraîné sur les mauvaises menaces, avec la même assurance tranquille qu’un LLM qui invente un endpoint API.
Alors, “nouvelle catégorie de modèle” ou régression en costume ?
La question mérite mieux qu’un rire de Panda, parce que la réponse est “les deux mon général, et ça n’est pas le point intéressant”.
Sur la forme, un modèle qui prend un état en entrée et sort une distribution de probabilités sur un ensemble fini de classes, c’est la définition littérale d’un classificateur supervisé. La contrainte de type n’est pas une prouesse d’entraînement, c’est une conséquence de l’architecture : il n’y a pas de tête de décodage autorégressive, donc il n’y a rien pour inventer un label hors vocabulaire. Vendre ça comme “zéro hallucination” revient à vendre une calculatrice comme “zéro faute d’orthographe”.
Trois choses sont pourtant réellement différentes, et il faut les reconnaître honnêtement.
Cette section continue dans la version complète, disponible gratuitement pour tous les abonnés Substack.
Le point aveugle : Jev classe une intention, pas une provenance
Voilà la critique qui me paraît la plus sérieuse, et elle ne vient pas du modèle mais de l’endroit où on le branche.
Cette section continue dans la version complète, disponible gratuitement pour tous les abonnés Substack.
L’appel légitime en apparence
Cette section continue dans la version complète, disponible gratuitement pour tous les abonnés Substack.
L’état empoisonné
Cette section continue dans la version complète, disponible gratuitement pour tous les abonnés Substack.
Le mode auto
Cette section continue dans la version complète, disponible gratuitement pour tous les abonnés Substack.
Un garde-fou dont la métrique de succès est “moins d’interruptions” finit toujours par optimiser les interruptions, pas la sécurité.
Le chiffre que personne ne met dans la démo
Un dernier point, purement arithmétique, qui décide en pratique de la viabilité du dispositif : le taux de base.
Cette section continue dans la version complète, disponible gratuitement pour tous les abonnés Substack.
Application a votre analyse STRIDE
Cette section continue dans la version complète, disponible gratuitement pour tous les abonnés Substack.
Mitigations
Si vous envisagez d’intégrer ce genre de classificateur dans votre propre harness d’agent (LangChain ou pas), quelques points concrets avant de faire confiance aveuglément au score :
Cette section continue dans la version complète, disponible gratuitement pour tous les abonnés Substack.
Quelques références pour aller plus loin
- Olivier Sauvage — Jev, la nouvelle IA ultra-performante
- LangChain Blog — Building a Harness with Jev
- TypeSafe AI — Introducing System One Models and Jev
- Agent harness : le code autour du modèle qui décide si votre agent est fiable ou pas
- CoreBreak : autorisation d’outils chez AWS, Google et Vercel
- Pourquoi Amazon se méfie du human-in-the-loop pour gouverner ses agents IA
- OpenAI resserre ses garde-fous, mais le bypass reste à portée de prompt
- GhostSplice : l’agent recolle tout seul l’instruction malveillante
- OWASP MCP Top 10 : les 10 menaces critiques du Model Context Protocol
- MCP05:2025 - Command Injection & Execution
- OWASP Top 10 LLM 2026 vs 2025 : ce qui a changé
- AI-Pods : l’équipe se rétrécit, la surface d’attaque grandit